El panorama: EmbeddingGemma 2: Google DeepMind lanza el modelo multimodal on-device que procesa texto, código, imágenes, audio y vídeo con 740 millones de parámetros
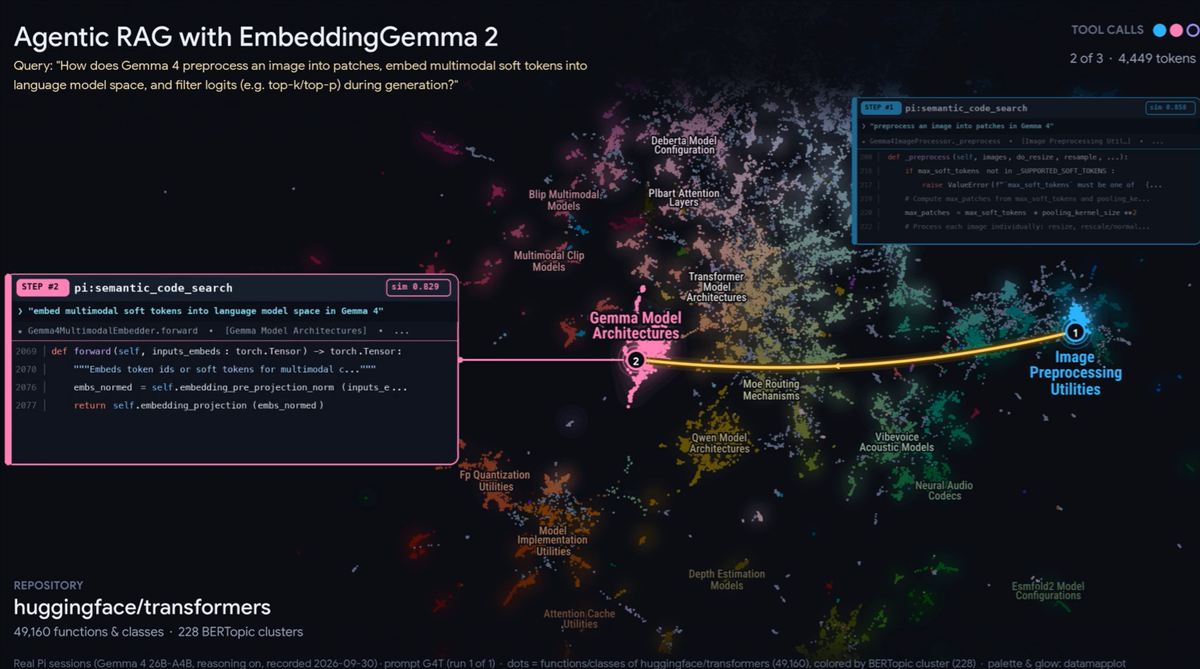
Google DeepMind publicó EmbeddingGemma 2, un modelo de representación multimodal de 740 millones de parámetros diseñado para ejecutarse directamente en el dispositivo del usuario sin necesidad de conexión a la nube. El modelo puede procesar texto, código, imágenes, audio y vídeo simultáneamente y genera representaciones vectoriales —embeddings— que permiten a las aplicaciones comparar, buscar y clasificar contenido multimodal con un único modelo unificado. El lanzamiento incluye licencia Apache 2.0, que permite el uso libre incluso en productos comerciales, y está construido sobre la arquitectura Gemma 4, la misma base de la familia de modelos abiertos de Google. La primera generación de Gemma acumuló 20 millones de descargas en sus primeros meses de disponibilidad: EmbeddingGemma 2 apunta a un caso de uso diferente pero con un potencial de adopción comparable.
Un embedding es una representación matemática compacta de un contenido —una imagen, un fragmento de texto, un clip de audio— en un espacio vectorial donde la distancia entre puntos indica similitud semántica. Dos imágenes del mismo perro tienen embeddings cercanos aunque sean fotos completamente diferentes; una imagen de un perro y la frase «cachorro de labrador» tienen embeddings cercanos aunque sean modalidades distintas. Eso permite buscar imágenes por descripción textual, recomendar vídeos similares a uno que acabas de ver, o detectar si una foto y un texto hablan del mismo tema: todas las tareas que hacen inteligentes a las aplicaciones de búsqueda y recomendación.
El problema hasta ahora era que la mayoría de modelos de embeddings multimodales de calidad corrían en la nube, lo que implicaba latencia de red y, más importante, que el contenido del usuario salía del dispositivo para ser procesado. EmbeddingGemma 2 trae esa capacidad al dispositivo con un tamaño de 740 millones de parámetros: suficientemente pequeño para correr en un smartphone de gama alta de 2024-2026 o en cualquier portátil moderno con aceleración de hardware, pero suficientemente capaz para producir embeddings de calidad comparable a los modelos cloud anteriores. Si el modelo corre en el teléfono, las fotos de la galería del usuario no tienen que salir del dispositivo para ser indexadas de forma inteligente.
Construir EmbeddingGemma 2 sobre Gemma 4 no es solo una decisión de ingeniería interna. Es una apuesta por la coherencia del ecosistema de desarrollo. Gemma 4 es la última generación de la familia de modelos abiertos de Google, y cualquier desarrollador que ya tenga experiencia optimizando aplicaciones con Gemma 4 puede transferir ese conocimiento a EmbeddingGemma 2 sin empezar desde cero: mismas herramientas de cuantización, mismas rutas de despliegue en Android con ML Kit o en TensorFlow Lite, mismo proceso de ajuste fino para dominios específicos.
Serás redirigido al portal original.